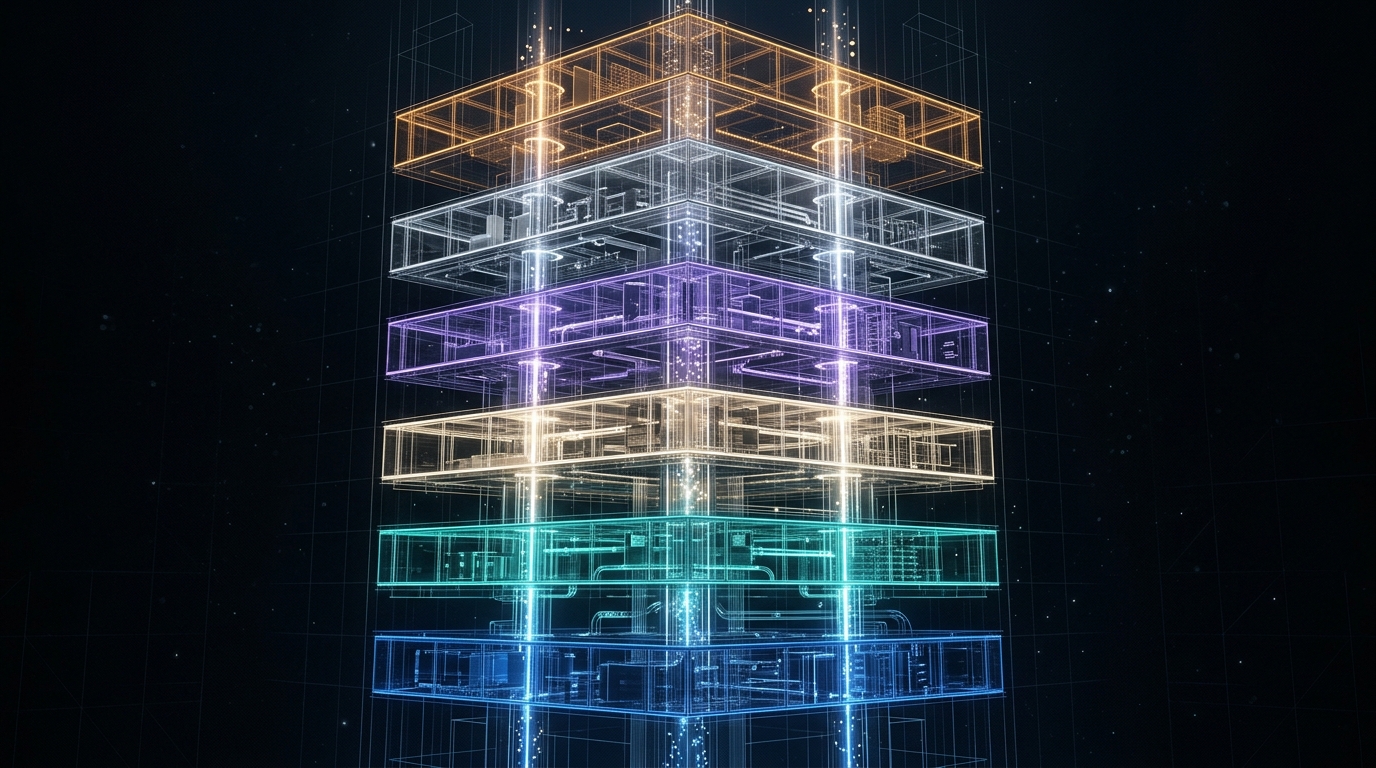
Toda organização que automatiza decisões de crédito enfrenta, em algum momento, a mesma crise arquitetural: o sistema que começou simples se transformou em um gargalo intransponível. A Decision Architecture (Arquitetura de Decisão) é o blueprint fundacional que determina se o seu motor de crédito escala de forma elástica ou entra em colapso sob alta concorrência.
No ecossistema de serviços financeiros, a latência e a escalabilidade são diferenciais competitivos. Uma arquitetura mal projetada não apenas atrasa a aprovação de uma proposta, mas compromete a conversão, inflaciona os custos operacionais (OpEx) com infraestrutura ineficiente e inviabiliza a rastreabilidade exigida por órgãos reguladores como o Banco Central do Brasil (BACEN). Projetar uma plataforma de decisão de crédito exige rigor técnico, padrões distribuídos avançados e uma compreensão profunda das interações entre microsserviços, persistência de dados e orquestração de regras.
Neste material, adotamos uma abordagem progressiva para desconstruir a anatomia de sistemas modernos de decisão. Exploraremos desde a teoria fundamental do Decision Stack até a implementação de padrões orientados a eventos, avaliando trade-offs entre monólitos modulares e microsserviços, e quantificando os impactos de protocolos de comunicação como gRPC e REST.
1. O que é Decision Architecture?
Decision Architecture é o design intencional, escalável e determinístico de como decisões lógicas são modeladas, processadas, executadas e auditadas em uma infraestrutura de software. Diferente da engenharia de software tradicional, onde o foco muitas vezes recai sobre transações de estado (CRUD), a arquitetura de decisão foca na avaliação de contexto em tempo real.
Para fintechs e instituições financeiras, a arquitetura de decisão é a espinha dorsal de qualquer motor de decisão de crédito. Ela deve garantir:
- Isolamento de Estado (Statelessness): Cada requisição de decisão deve conter todo o contexto necessário ou ser capaz de hidratá-lo rapidamente, sem depender de sessões de longa duração.
- Determinismo: Para os mesmos inputs (dados de bureau, score, perfil), o motor deve produzir exatamente o mesmo output, essencial para backtesting e explicabilidade.
- Latência P99 Estrita: A capacidade de responder a 99% das requisições em uma janela de tempo fixa (geralmente inferior a 500ms).
- Desacoplamento do Ciclo de Vida: A lógica de negócio (regras) deve evoluir independentemente do código-fonte dos microsserviços de infraestrutura.
The 6-Layer Decision Stack
Para organizar essa complexidade, a indústria adota o modelo de 6 camadas (6-Layer Decision Stack), que abstrai as responsabilidades do sistema de forma ortogonal:
- Data Layer (Ingestão e Hidratação): Responsável pela captura de dados (bureau, Open Finance, antifraude), cache e padronização de features.
- Orchestration Layer: O maestro do fluxo. Define a topologia de execução (DAG - Directed Acyclic Graph), paraleliza chamadas e gerencia timeouts.
- Policy Layer (Business Rules): Onde residem as matrizes de corte, tabelas de decisão e regras de elegibilidade booleanas.
- Intelligence Layer (Machine Learning): Executa escoragem de modelos preditivos (XGBoost, Random Forest, Redes Neurais).
- Governance Layer: Gerencia o ciclo de vida, versionamento, aprovações (RBAC) e simulações em shadow mode.
- Observability Layer: Coleta telemetria, logs de execução estruturados e rastreia cada ramificação condicional para auditoria (compliance).
2. Microservices vs Monolith vs Modular Monolith: Trade-offs para Decisioning
O debate arquitetural clássico se manifesta fortemente em motores de decisão. Enquanto a década passada foi dominada pelo êxodo para microsserviços, evidências empíricas e restrições de latência trouxeram o Monólito Modular de volta aos holofotes.
Um estudo recente sobre concorrência massiva indica que arquiteturas baseadas em microsserviços apresentam maior throughput em cenários de alta concorrência devido à capacidade de escalabilidade horizontal independente de componentes individuais [Fonte: Arxiv, 2023]. Contudo, essa vantagem cobra um preço alto em complexidade de rede e serialização.
| Dimensão | Microsserviços Distribuídos | Monólito Tradicional | Monólito Modular |
|---|---|---|---|
| Latência Base | Alta (Network hops, serialização JSON) | Baixa (Chamadas em memória) | Baixa (Chamadas em memória) |
| Escalabilidade | Granular (por componente) | Vertical e Horizontal (bloco inteiro) | Vertical e Horizontal (bloco inteiro) |
| Manutenibilidade | Complexa (Dependency Hell) | Difícil (Alto acoplamento) | Excelente (Fronteiras lógicas claras) |
| Adequação para Decisão | Bom para integrações de terceiros lentas | Anti-pattern para evolução rápida | Ideal para o core engine de regras |
A lição da indústria de streaming se aplica ao setor financeiro: em 2023, o Amazon Prime Video publicou um estudo de caso notório onde migraram uma arquitetura de microsserviços serverless de volta para um monólito, resultando em uma redução maciça na latência e um corte substancial de custos [Fonte: AWS, 2023]. Para a execução pura de credit decisioning, onde o tempo de rede domina o tempo de CPU, empacotar a execução das políticas no mesmo processo (Monólito Modular) muitas vezes supera o overhead de múltiplos hops de microsserviços.
3. Deep Dive: The Decision Stack Layers
Vamos detalhar a arquitetura de cada componente da pilha de decisão e como eles interagem em um ambiente de produção (Tier 1).
3.1. Data Layer: Hidratação e Caching Estratégico
Nenhuma decisão é melhor do que os dados que a alimentam. O Data Layer em uma arquitetura de alta performance não faz fetch de dados síncronos se puder evitar. A estratégia correta envolve a pré-computação de features e o uso de caches em memória ultra-rápidos (ex: Redis, Memcached).
Em operações de crédito no Brasil, a dependência de APIs externas (Serasa, Boa Vista, SCR do BACEN) insere variabilidade de latência. A arquitetura deve empregar padrões de Circuit Breaker (ex: Resilience4j) e Fallbacks gracefully (ex: aprovar com base no score interno se o bureau falhar, assumindo risco calculado).
3.2. Orchestration Layer: O Motor de Fluxo
Diferente de um BPM (Business Process Management), a orquestração de decisão precisa ser otimizada para micro-segundos. Ela lê a definição do fluxo (geralmente um JSON ou YAML gerado pelo Sinky Studio) e compila isso em um Grafo Direcionado Acíclico (DAG) na memória. A orquestração resolve as dependências: se a "Regra B" e a "Regra C" dependem dos dados da "Integração A", o orquestrador dispara B e C paralelamente assim que A retorna.
3.3. Policy Layer: Execução Stateless
O coração do sistema. As políticas (regras de corte, políticas de concessão) devem ser stateless functions. Elas recebem o JSON de contexto e retornam um JSON de resultado. Ao manter essa camada stateless, o autoscaling no Kubernetes pode instanciar milhares de pods baseados na métrica de utilização de CPU, garantindo disponibilidade irrestrita durante picos de originação (ex: Black Friday, campanhas de marketing agressivas).
3.4. Intelligence Layer: Model Serving
Modelos de Machine Learning exigem recursos diferentes das regras. Enquanto regras consomem CPU, modelos profundos podem consumir GPU ou grandes blocos de memória RAM. A arquitetura ideal isola o Model Serving (ex: Triton Inference Server, Seldon Core, MLflow) e expõe os scores preditivos como APIs internas (via gRPC) para o orquestrador de decisão. Isso permite escalar os contêineres de IA separadamente dos contêineres lógicos.
3.5. Governance Layer: Auditabilidade Imutável
O Banco Central (Resolução CMN 4.893 e BCB 85) e a LGPD exigem rastreabilidade de algoritmos. A governança arquitetural impõe que toda política publicada seja associada a um hash criptográfico. Nenhum deployment é feito diretamente; utiliza-se CI/CD para pipelines de decisão, onde um repositório Git atua como Source of Truth (GitOps para regras).
3.6. Observability Layer: Telemetria e Logs Estruturados
Monitorar uma Decision Infrastructure exige três pilares: Traces, Métricas e Logs. O OpenTelemetry se tornou o padrão ouro. Cada requisição recebe um trace_id. A latência de cada etapa (consulta ao bureau de fraude, execução da regra de idade, cálculo do limite) é mensurada. Logs não devem ser textos livres, mas objetos estruturados indexados em bancos de dados analíticos (Elasticsearch, ClickHouse) para permitir agregações complexas ("Qual a latência P95 das recusas da política V2?").
4. Padrões de Comunicação: REST vs gRPC vs Mensageria Async
A forma como os componentes do seu ecossistema de crédito se comunicam determina a escalabilidade térmica e a resiliência do todo. Quando tratamos de latência em decisão de crédito, a sobrecarga de serialização pode representar até 40% do tempo total de processamento em arquiteturas mal otimizadas.
O Paradigma Síncrono: gRPC destroça o REST
Enquanto REST sobre HTTP/1.1 com payloads JSON é legível e universal, é fundamentalmente ineficiente para comunicação intra-cluster. O JSON exige parsing intensivo de CPU, e o HTTP/1.1 sofre com o bloqueio de linha de cabeça (head-of-line blocking).
O gRPC, estruturado sobre HTTP/2 e empregando Protobuf (Protocol Buffers) para serialização binária, altera radicalmente essa matemática. Os dados são compactados e os canais são multiplexados.
Estudos de benchmarking revelam vantagens absolutas de performance. Testes de estresse independentes demonstraram que o gRPC é de 7 a 10 vezes mais rápido que chamadas REST tradicionais [Fonte: BoldSign, 2024]. Além da latência pura, a capacidade de vazão (throughput) é substancialmente maior, suportando de 3.4 a 4 vezes mais requisições por segundo em comparação ao REST no mesmo hardware [Fonte: L3montree, 2023].
| Protocolo | Mecanismo de Serialização | Throughput (req/s) relativo | Caso de Uso na Decisão |
|---|---|---|---|
| REST (HTTP/1.1) | JSON (Texto, alto overhead) | 1x (Baseline) | Exposição de APIs para o front-end / parceiros externos. |
| gRPC (HTTP/2) | Protobuf (Binário, tipado) | 3.4x a 4x | Comunicação interna do motor de regras, Model Serving (Machine Learning). |
| Async (Kafka/RabbitMQ) | Avro / Protobuf / JSON | Alto (Bufferizado) | Auditoria, consolidação de eventos para Data Lake, emissão de notificações assíncronas. |
Para arquiteturas críticas de decisão, a recomendação (Best Practice) é padronizar todo o tráfego east-west (dentro do cluster de servidores) utilizando gRPC, reservando o REST exclusivamente para o tráfego north-south (clientes externos).
5. Event-Driven Patterns: CQRS e Event Sourcing para Decisões
O fluxo tradicional de "Request -> Processamento -> Persistência -> Response" esbarra em limites físicos de bancos relacionais tradicionais sob extrema carga. Adotar padrões Event-Driven revoluciona a capacidade de auditoria e a resiliência.
Event Sourcing
Na arquitetura orientada a eventos, o estado de uma proposta de crédito não é atualizado com comandos UPDATE num banco de dados relacional. Em vez disso, cada mudança de estado (Ex: Dados do Bureau Recebidos, Regra de Renda Aprovada, Decisão Final Recusada) é apendada como um evento imutável em um log (ex: Apache Kafka ou EventStore). O estado atual é a projeção desses eventos.
Isso resolve elegantemente o problema de audit trail (trilha de auditoria). Se o regulador questionar por que uma linha de crédito foi negada em 14 de maio de 2025, o sistema simplesmente reproduz os eventos imutáveis registrados naquele milissegundo. Nenhuma deleção de dados é permitida. Apenas compensações.
CQRS (Command Query Responsibility Segregation)
Separar as operações de escrita (Commands: submeter proposta, aprovar limite) das operações de leitura (Queries: listar propostas aprovadas do cliente, gerar relatório de originação diária). O motor de decisão opera apenas do lado de Commands, gerando eventos assíncronos que atualizam bancos de dados de leitura (Read Models) otimizados para busca (como Elasticsearch), garantindo que a execução do crédito nunca concorra por recursos de banco de dados com dashboards de BI.
6. Scalability Patterns: Engenharia para o Hipercrescimento
Para escalar um sistema de decisão de algumas centenas para milhões de avaliações diárias, a arquitetura deve implementar três padrões centrais de escalabilidade:
- Horizontal Scaling e Stateless Design: Conforme mencionado, a ausência de estado em memória local nos nós de processamento permite adicionar instâncias indiscriminadamente (scale-out). Cada worker é descartável. O estado da decisão em andamento deve residir em datastores distribuídos (ex: Redis Cluster).
- Stale-While-Revalidate Caching: A obtenção de dados de birôs externos é o calcanhar de Aquiles da latência. Usando o padrão de cache stale-while-revalidate, o sistema pode tomar decisões instantâneas com dados que estão "ligeiramente" desatualizados (ex: score de bureau de ontem) e, assincronamente em background, disparar a renovação do dado para a próxima consulta. O negócio define a janela de tolerância de staleness de acordo com o apetite de risco.
- Bulkheads (Compartimentação): Isolamento de falhas. Se a integração de Open Finance estiver lenta e enfileirando threads, o padrão bulkhead impede que essas threads paralisem o pool de conexões usado para operações puramente internas. A lentidão de um componente não causa uma cascata de falhas no sistema inteiro.
7. O Anti-Pattern do "Distributed Monolith"
O erro arquitetural mais devastador e comum em instituições que tentam modernizar seus motores legados é a criação de um Monólito Distribuído. Ele surge quando a equipe adota "microsserviços" fragmentando o domínio de forma excessivamente granular e, em seguida, os amarra com chamadas síncronas bloqueantes (REST).
O Cenário: O Microsserviço de Orquestração chama o Microsserviço de Fraude (espera 200ms), que chama o Microsserviço de Identidade (espera 150ms). Se o Microsserviço de Renda falha temporariamente, tudo quebra. A disponibilidade do sistema passa a ser a multiplicação das disponibilidades dos nós (0.99 x 0.99 x 0.99 = 0.97). Isso corrói a disponibilidade P95 e degrada drasticamente a latência sem oferecer nenhum dos benefícios prometidos pela escalabilidade independente, pois os serviços estão temporalmente acoplados.
A Solução: Evitar chamadas em cadeia profunda (daisy-chaining). Adotar a orquestração central (onde um supervisor síncrono coordena os retornos paralelizados sem cascata) ou coreografia guiada por eventos. Além disso, reavaliar as fronteiras do domínio: lógica que sofre alterações ao mesmo tempo e pertence à mesma transação de negócio deve, frequentemente, ser agrupada em um Monólito Modular bem estruturado.
8. Arquitetura de Referência: A Abordagem Moderna
Sintetizando as práticas da indústria, uma arquitetura de referência ideal para decisão de risco em Tier-1 se assemelha a este fluxo topológico:
- O canal de originação (App, Web, API Parceiro) envia um POST para um API Gateway com terminação SSL, aplicando rate limiting e validação de schema primária.
- A requisição alcança o Decision Gateway, que dispara a execução do grafo orquestrado pelo motor (Monólito Modular core-logic).
- O Orquestrador interage com as APIs internas de Enriquecimento de Dados usando gRPC e pools paralelos. Os microsserviços de dados verificam o Cache Distribuído (Redis) antes de onerar bureaus parceiros (Serasa, SPC).
- De posse dos dados hidratados, o orquestrador aciona a execução pura das políticas em memória. Latência dessa etapa: sub-10ms.
- Resultados da política são emitidos de volta ao gateway, que responde de imediato ao canal solicitante de forma síncrona, encerrando a conexão do cliente (Fast Response).
- Assincronamente, num padrão Fire-and-Forget com garantias no message broker (Kafka), os eventos detalhados do resultado (Trilha de Decisão) são despejados num Data Lake (S3/Delta Lake) para modelagem, auditoria regulatória e BI.
9. Como a Sinky implementa Decision Architecture
A filosofia de arquitetura da Sinky absorve essa complexidade e entrega a abstração pronta para as áreas de negócio e engenharia das instituições financeiras. O design da plataforma da Sinky foi concebido com os princípios cloud-native desde o dia zero.
Ao invés de obrigar sua equipe a lidar com o "distributed monolith trap" ou codificar infraestrutura gRPC manualmente, a Sinky entrega:
- Sinky Studio: Uma interface visual robusta e user-friendly, mas que atua essencialmente como um compilador de árvores abstratas de sintaxe. Você desenha os nós, e a arquitetura compila isso em grafos de execução serializados e hiperformáticos.
- Sinky Consulta (Integration Hub): Uma camada de hidratação otimizada, já dotada de cache distribuído em memória e circuit breakers avançados para mais de 100 provedores de dados e birôs, encapsulando a complexidade de rede.
- Sinky Analytics: Implementa o conceito de Event Sourcing nativamente, ingerindo cada decisão processada para fornecer dashboards em tempo real, retroativamente rastreáveis e que suportam backtesting em escala de Big Data sem comprometer a performance do processamento transacional (separação tipo CQRS).
Na arquitetura Sinky, cada decisão se beneficia de latências baixíssimas, failovers automáticos e governança algorítmica rigorosa, libertando a TI para inovar no core business da instituição, enquanto a engine de risco processa decisões com a eficiência que o mercado hipercompetitivo moderno demanda.
Perguntas Frequentes (FAQ)
Qual a vantagem real do Monólito Modular sobre Microsserviços para motores de decisão?
Enquanto microsserviços oferecem escalabilidade granular, o tráfego de rede intenso necessário para processar dezenas de pequenas regras distribuídas (via JSON sobre REST, por exemplo) introduz latência severa. Um monólito modular acopla a execução na mesma memória RAM, mantendo os módulos do código separados logicamente (boa manutenibilidade), eliminando o delay da rede interna. Isso resulta em P99 de latências muito mais baixas, sendo ideal para execuções sequenciais de regras de alta densidade.
Como o gRPC melhora a arquitetura de crédito comparado ao REST?
O gRPC usa HTTP/2 e serialização binária compacta (Protobuf), permitindo o envio de múltiplos fluxos simultâneos numa mesma conexão. Dados mostram que ele processa 3.4x a 4x mais requisições por segundo e chega a ser 10x mais rápido que o REST convencional. Em sistemas onde cada decisão exige que o motor consulte 5 ou 6 microsserviços de IA ou dados internamente, o gRPC zera praticamente o "imposto de comunicação", otimizando drasticamente a infraestrutura.
O que é o anti-pattern de Monólito Distribuído e como impacta o P95?
Ocorre quando a arquitetura é dividida em serviços menores que dependem de chamadas síncronas diretas (um chama o outro que chama o outro). Isso cria uma fragilidade acoplada em rede: a lentidão de um único serviço de ponta penaliza toda a cadeia de execução de decisão. A latência P95 (o tempo em que 95% das requisições são resolvidas) dispara devido a enfileiramentos (queues) na rede e timeouts excessivos. Evita-se isso usando padrões de Event-Driven ou Orquestração com paralelismo assíncrono rigoroso.
Como a arquitetura baseada em eventos (Event Sourcing) ajuda no Compliance do BACEN?
Em Event Sourcing, em vez de sobreescrever o estado num banco de dados relacional, o sistema armazena cada mudança de estado (a entrada da requisição, a saída do score, a política que barrou) como um evento imutável em um log (como Kafka). Isso fornece uma trilha de auditoria natural e incólume a falsificações, permitindo reconstruir frame by frame os motivos de uma aprovação ou recusa a qualquer momento no futuro, atendendo 100% às exigências de explicabilidade de algoritmos dos órgãos reguladores.